lunes, mayo 22, 2006
Servicios declarativos de cache
En el artículo Declarative Caching Services for Spring, Alex Ruiz nos muestra como utilizar diferentes proveedores de cache con los Spring Modules de Spring 2.0

lunes, febrero 27, 2006
Hibernate Annotations
Introducción
Uno de los problemas mas frecuentes al trabajar con Hibernate, es la generación de los mapping files. (archivos .hbm.xml). Hay varias opciones para generarlos, desde escribirlos a mano hasta usar varios de los generadores automáticos. La manera mas usual es usar Xdoclet, algo que a mi particularmente nunca me gustó, ya que agrega un paso mas a la compilación, obligándome a usar Ant todo el tiempo, y no es algo que me parezca muy productivo. Además Xdoclet 1 no es del todo compatible con Hibernate 3 (la solución sería usar Xdoclet2, pero yo nunca lo probé). Hay otras opciones también, como algunos plugins para Eclipse, pero tampoco me terminaron de convencer.Presentando Hibernate Annotations
Hibernate Annotations es un proyecto paralelo de Hibernate, a fin de proveer compatibilidad con la nueva especificación de EJB3.
Junto con otro proyecto, HibernateEntityManager , la gente de Hibernate planea tener un framework 100% compatible con EJB3, sin necesidad de un application server.
La especificación de EJB3 aún no esta completa, pero esta muy avanzada, y es de esperar que si hay algunos cambios, sean menores. Igualmente no es necesario usar EntityManager para aprovechar las anotaciones.
EJB3, aunque inspirado en Hibernate, no provee toda la funcionalidad de éste, por lo que Hibernate Annotations ofrece unas extensiones (en el paquete hibernate-annotations.jar) para lograr la misma funcionalidad que con los mappings files, pero es de suponer que esta compatibilidad sera alcanzada recién en la versión definitiva (actualmente esta disponible la 3.1beta8).
Además, Hibernate Annotations es compatible con los mappings, por lo que ambos pueden convivir en una misma aplicación, de forma que se puede ir migrando una aplicación de a poco (por supuesto cada clase individual debe estar mapeada de una u otra manera, no se pueden combinar los dos estilos en una misma clase).
Para los que no estén familiarizados con java annotations, les recomiendo que lean algún artículo en internet, como por ejemplo este.
Cuando se usa Hibernate Annotations, no significa que Hibernate va a crear los mapping files por sí mismo, y luego los va a leer y procesar. Hibernate toma las clases que tiene declaradas en el hibernate.cfg.xml, y lee las anotaciones directamente desde los archivos .class, generando así los mappings en memora en tiempo de ejecución.
Una gran ventaja de usar Hibernate Annotations es que todos los IDE modernos (Eclipse, IntelliJ, etc.), tienen soporte para anotaciones en el editor. Esto significa que es posible usar todas las funciones de los IDE (auto completar, refactoring, etc.) también con las anotaciones.
Por otra parte, todos los atributos de las anotaciones son tipos java (String, int, boolean, etc.), con lo que se reduce aún mas la posibilidad de errores.
Instalación
Es tan simple como agregar los jar (hibernate-annotations.jar y ejb3-persistence.jar) provistos en la distribución al classpath. También, donde sea que se defina el sessionFactory, hay que usar la clase AnnotationConfiguration en vez de Configuration (si se esta usando Spring, se debe usar AnnotationSessionFactoryBean en lugar de LocalSessionFactoryBean).Por ultimo, en el archivo hibernate.cfg.xml hay que indicar que clases van a ser persistentes, de manera similar a cuando definíamos los mappings:
<mapping class="test.Cliente"/>
Hibernate Annotations requiere Hibernate 3.1.1 o superior.
Breve introducción a las Hibernate Annotations
Esto no pretende ser ni un tutorial ni una referencia completa a Hibernate Annotations, sino simplemente un pantallazo sobre su utilización. Para mas información y detalles, consulten la documentación en el sitio de Hibernate.Otra de las grandes ventajas de usar annotations, es que podemos ir escribiendo los mapeos a medida que vamos escribiendo nuestra clase. Además, como la especificación provee defaults para casi todas las annotations, en principio hacer que una clase sea persistente es tan simple como agregar una sola anotación:
@EntityEn este caso, la clase mapearia a una tabla en la BD llamada cliente, con un campo de tipo texto llamado nombre.
public class Persona {
...
public String getNombre() {
...
}
}
Por supuesto nunca tendremos tanta suerte, y siempre será necesario agregar algo mas para que las clases mapeen correctamente a la tablas.
Por ejemplo, para que la tabla se llame “PERSONAS”, podemos agregar la siguiente anotación a la clase:
@Table(name=”PERSONAS”)Todas la propiedades de la clase que tengan un getter van a ser persistentes por default (excepto las marcadas con static o transient), lo que equivaldría a usar la anotación @Basic;
@BasicSi queremos que algún campo no sea persistente, lo marcamos con @Transient:
public Date getFechaDeNacimiento() {
...
}
@TransientFinalmente, si queremos cambiar alguna de las características de la columna en la BD, podemos usar @Column:
public int getEdad() {
...
}
@Column(name=”documento”, unique=true, nullable=false, length=10)Veamos ahora como mapear algunas asociaciones, empezando por la mas simple @OneToOne:
public String getNroDocumento() {
...
}
@EntityNoten como puede especificar el tipo de cascada que quiero. La columna que relacione las dos tablas en la BD se llamará por default direccion_id, en base a la concatenación del nombre de la relación mas underscore, mas el nombre de la primary key de la clase contenida. En caso de querer usar otro nombre de columna, se puede usar @JoinColumn.
public Class Persona {
@OneToOne(cascade=CascadeType.All)
public Direccion getDireccion() {
...
}
}
@Entity
public Class Direccion {
...
}
Esta es una asociación unidireccional, si quisiera que fuera bidireccional, agrego en la clase Direccion:
@OneToOne(mappedBy=”direccion”)En vez de repetir el mapeo, simplemente lo especificamos con mappedBy, Hibernate busca el mapeo que se hizo en otro extremo de la asociación y sabe que es la asociación inversa.
public Persona getPersona() {
...
}
Si una empresa tiene muchas personas, uso @ManyToOne:
@EntityPara el caso de colecciones (por ejemplo si una persona tiene mas de una dirección), se usa @OneToMany/@ManyToOne o @ManyToMany:
public Class Persona {
@ManyToOne()
@JoinColumn(name=”empresa_id”)
public Empresa getEmpresa() {
...
}
}
@Entity
public Class Empresa {
...
}
@EntitySi usamos colecciones genéricas, Hibernate deduce cual es el otro extremo de la asociación y no es necesario indicarlo. En el caso que no usemos genéricas, o bien usemos interfaces, debemos indicar explícitamente hacia adonde apunta la asociación mediante el atributo targetEntity.
public Class Persona {
@OneToMany(mappedBy=”persona”)
public List<Direccion> getDirecciones() {
...
}
}
@Entity
public Class Direccion {
@ManyToOne
public Persona getPersona() {
...
}
}
Desventajas de Hibernate Annotations
- La especificación no es definitiva: esto implica que aun puede haber cambios a las anotaciones, y en caso de que eso suceda, habrá que modificarlas en nuestras clases. Igualmente, creo que a esta altura, los cambios serian mínimos y no costaría mucho realizarlos.
- Requiere JVM 1.5: Las anotaciones es una característica del JDK 1.5. Esto no es un problema en un proyecto nuevo, pero si se quiere migrar código preexistente, puede que instalar JVM 1.5 en un entorno de producción sea un problema y no se pueda realizar fácilmente.
- No todas las posibilidades de Hibernate están soportadas: Hay algunos mapeos que se pueden hacer en los mapping files que no se pueden hacer con anotaciones (por ejemplo ciertos mapeos con Maps, o OneToMany/ManyToOne bidireccional con una tabla intermedia), pero esto es probablemente una situacion temporaria hasta que haya una versióndefinitiva de Hibernate Annotations (la gente de Hibernate apunta a que sea 100% compatible con mapping files).
Conclusión
Hibernate Annotations es una excelente adición a Hibernate, y si no tienen problemas con las desventajas enunciadas anteriormente, en mi opinión es el camino a seguir.Particularmente acabo de migrar una aplicación mediana (30 entidades) a Hibernate Annotations con un excelente resultado. Además, trabajar con anotaciones me resultó muy cómodo, mas fácil y mas intuitivo que con los mapping files o que con Xdoclet.
domingo, febrero 12, 2006
Performance Testing con JUnitPerf
Una forma muy recomendable de probar la performance de nuestra aplicación es comprobar la performance de los mismos componentes a los cuales les generamos un test unitario (generalmente con JUnit). Si además estas pruebas son también junits, podremos agregarlas al conjunto de pruebas que hacemos continuamente en nuestra aplicación, ya sea manualmente al desarrollar o mediante un continuous build server (por ejemplo CruiseControl).
Todo esto lo podremos lograr con JUnitPerf, una colección de decoradores para medir la performance de tests JUnit.
Por ejemplo, si tenemos un JUnit SimpleTest con el método testAnything:
También podemos medir la performance simulando una carga de usuarios concurrentes, como en este ejemplo:
Todo esto lo podremos lograr con JUnitPerf, una colección de decoradores para medir la performance de tests JUnit.
Por ejemplo, si tenemos un JUnit SimpleTest con el método testAnything:
public class SimpleTest extends TestCase {
    ...
    public void testAnything() throws Exception {
        ...
    }
}
podemos hacer una clase de test que pruebe la performance del método testAnything creando un nuevo JUnit y utilizando los decoradores de JUnitPerf:public class SimpleResponseTimeTest {
public static Test suite() {
long maxTime = 500;
Test test = new SimpleTest("testAnything");
Test timedTest = new TimedTest(test, maxTime);
return timedTest;
}
public static void main(String args[]) {
junit.textui.TestRunner.run(suite());
}
}En este caso el test fallará si dura mas de 0,5 segundos.También podemos medir la performance simulando una carga de usuarios concurrentes, como en este ejemplo:
public class SimpleLoadTest {
    public static Test suite() {
        long maxTime = 500;
        int concurrentUsers = 5;
        Test test = new SimpleTest("testAnything");
        Test timedTest = new TimedTest(test, maxTime);
        Test loadTest = new LoadTest(timedTest, concurrentUsers);
        return loadTest;
    }
    public static void main(String args[]) {
        junit.textui.TestRunner.run(suite());
    }
}
A las clases LoadTest y TimerTest se le puede pasar también una instancia de RepeatedTest, para medir no sólo una ejecución del test sinó varias, por ejemplo:public class SimpleLoadTest {
public static Test suite() {
int users = 10;
int iterations = 20;
Timer timer = new ConstantTimer(500);
Test test = new SimpleTest("testAnything");
Test repeatedTest = new RepeatedTest(test, iterations);
Test loadTest = new LoadTest(repeatedTest, users, timer);
return loadTest;
}
public static void main(String args[]) {
junit.textui.TestRunner.run(suite());
}
}Para mas opciones sobre la herramienta, no queda mas que visitar la web de JUnitPerf, o este otro artículo: Continuous Performance Testing With JUnitPerf.
domingo, octubre 16, 2005
Spring XBean
Un interesante proyecto que apareció últimamente en la web (via Spring-Loaded) es XBean.
Este proyecto nos permite "modificar" las etiquetas XML del fichero de configuración de Spring para poder escribir:
en lugar de:
Aunque parezca que estamos "desnaturalizando" la definición del xml de configuración de Spring, en muchos casos esto es mas que útil. Por ejemplo, cuando queremos que el usuario final tenga acceso a configurar parte de la aplicación. Es mucho mas sencillo en ese caso que se aprendan una sintaxis "especial", que la sintaxis Spring. Además de mantener el tamaño de los ficheros en algo mas razonable.
Para poder hacer esta "magia", debemos agregar los jars de XBean al proyecto, generar un fichero en el classpath con los alias y utilizar ClassPathXmlApplicationContext (o sus similares) del package org.xbean.spring.context en lugar de los normales de Spring.
El fichero de alias deberá estar bajo "META-INF/services/org/xbean/spring/", y llamarse igual que la url que hayamos elegido para el XML namespace. En este ejemplo el path completo sería META-INF/services/org/xbean/spring/http/example.com/schemas/config, y el fichero config debería contener:
e incluso podríamos ahorrarnos algunos alias si nuestras propiedades se llaman igual que nuestras etiquetas y agregamos
en el fichero.
Este proyecto nos permite "modificar" las etiquetas XML del fichero de configuración de Spring para poder escribir:
<configuracion url="http://www.myurl.com"
     xmlns="http://example.com/schemas/config">
  <myDao><dao/></myDao>
  <roles>
    <rol key="admin"/>
    <rol key="user"/>
  </roles>
<configuracion>
en lugar de:
<bean id="configuracion" class="mypackage.Configuracion">
  <property name="url" value="http://www.myurl.com"/>
  <property name="dao" ref="dao"/>
  <property name="roles">
    <list>
      <value>
        <bean class="mypackage.Rol">
          <property key="admin"/>
        </bean>
      </value>
      <value>
        <bean class="mypackage.Rol">
          <property key="user"/>
        </bean>
      </value>
    </list>
  </property>
</bean>
<bean id="dao" class="mypackage.ConfiguracionDAO"/>
Aunque parezca que estamos "desnaturalizando" la definición del xml de configuración de Spring, en muchos casos esto es mas que útil. Por ejemplo, cuando queremos que el usuario final tenga acceso a configurar parte de la aplicación. Es mucho mas sencillo en ese caso que se aprendan una sintaxis "especial", que la sintaxis Spring. Además de mantener el tamaño de los ficheros en algo mas razonable.
Para poder hacer esta "magia", debemos agregar los jars de XBean al proyecto, generar un fichero en el classpath con los alias y utilizar ClassPathXmlApplicationContext (o sus similares) del package org.xbean.spring.context en lugar de los normales de Spring.
El fichero de alias deberá estar bajo "META-INF/services/org/xbean/spring/", y llamarse igual que la url que hayamos elegido para el XML namespace. En este ejemplo el path completo sería META-INF/services/org/xbean/spring/http/example.com/schemas/config, y el fichero config debería contener:
configuracion=mypackage.Configuracion
configuracion.myDao=dao
dao=mypackage.ConfiguracionDAO
rol=mypackage.Rol
e incluso podríamos ahorrarnos algunos alias si nuestras propiedades se llaman igual que nuestras etiquetas y agregamos
mypackage=package
en el fichero.
viernes, septiembre 30, 2005

martes, agosto 30, 2005
DWR y Spring
DWR (Direct Web Remoting) o "Easy AJAX for Java" es una biblioteca para facilitar la utilización de AJAX. Y con AJAX (Asynchronous JavaScript And XML for Web GUI processing) podemos actualizar una página web sin necesidad de gets y posts, eliminando el correspondiente "roundtrip" al servidor y refrescos de páginas, logrando una interfaz similar a cualquier aplicación desktop.
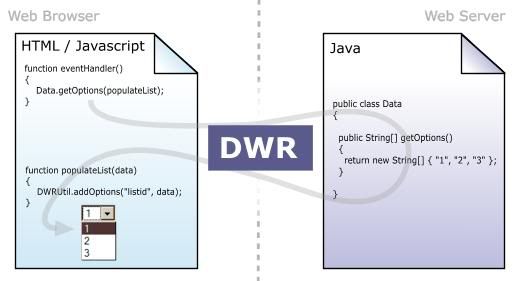
DWR expone métodos de una clase Java utilizando Javascript, permitiendo asi su acceso desde cualquier página web (HTML/JSP/etc):
¿Pero cómo se configura DWR y cómo logramos que esa clase Java sea un bean de Spring?
Luego de copiar dwr.jar al servidor, configuraremos DWR en el WEB-INF/web.xml de la aplicación:
Luego crearemos un fichero WEB-INF/dwr.xml donde especificaremos qué métodos de qué beans queremos "exponer" mediante dwr, y que beans van a servir de transporte de datos y por lo tanto dwr debe convertir.
Por ejemplo, si queremos llenar una lista desplegable con categorías (paises, por ejemplo) y otra dependiente de esta (ciudades), necesitamos dos métodos de un bean Java (ciudadesManager), y un DTO para transferencia de datos (ListBean).
Consecuentemente, en nuestro beans.xml estará el bean ciudadesManager:
Llegados a este punto, lo que queda es desarrollar la página de nuestra aplicación, y para ello deberemos incluir el javascript necesario para acceder al ciudadesManager (recordando actualizar el [appfolder]:
El primer include corresponde al javascript que DWR generará automaticamente para nuestro bean ciudadesManager, el segundo es el core de DWR, y el tercero una serie de utilidades para manipular controles html, como gets y sets de propiedades.
Las funciones javascript necesarias para acceder remotamente a los métodos del bean se dividen en dos: uno que hace la llamada y otro de callback. Asi, para llenar la lista de paises crearemos las funciones execPaises y fillPaises, y para llenar la lista de ciudades execCiudades y fillCiudades:
La primer funcion, execPaises, la llamaremos al inicio de la página, dentro del onLoad del body. Al ejecutarse, llamará al método getPaises de ciudadesManager y el resultado lo tendremos en la función que le pasemos como parámetro, en este caso fillPaises.
Dentro de fillPaises utilizaremos la función DWRUtil.fillList para rellenar la lista desplegable cuyo id es paises con la lista de datos recibidos, diciéndole cuál propiedad corresponde al código y cuál a la descripción.
Análogamente, la función execCuidades estará en el onChange de la lista paises, y cuando se ejecute (cada vez que cambiemos de pais) borrará todas las opciones de la lista ciudades y ejecutará el método getCiudades, pasando como parámetro el value de la lista paises (el pais elegido).
El código de las listas quedará asi:
Solo nos queda codificar el bean ciudadesManager y el DTO. El manager obtiene la lista de paises o ciudades utilizando un DAO y las trasnfiera al DTO. Cabe señalar que podríamos utilizar directamente los beans Pais y Ciudad y transferirlos a la página, pero estas clases suelen tener muchas mas propiedades que no utilizaríamos y penalizaría la performance. De cualquier modo dependerá de vuestra propia aplicación como hacerlo, esta es solamente una forma mas.
 Si todo ha sido configurado correctamente, el resultado será una lista desplegable de paises que se llena al cargar la página:
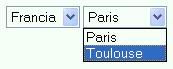
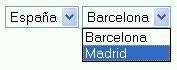 y una lista desplegable de ciudades que se refresca cada vez que cambiamos la primera:
Y todo sin que se refresque la página.
En el sitio de DWR hay numerosos ejemplos de como utilizarlo para diversas tareas, como editar tablas y formularios o validar datos, solo hace falta animarse.
DWR expone métodos de una clase Java utilizando Javascript, permitiendo asi su acceso desde cualquier página web (HTML/JSP/etc):
¿Pero cómo se configura DWR y cómo logramos que esa clase Java sea un bean de Spring?
Luego de copiar dwr.jar al servidor, configuraremos DWR en el WEB-INF/web.xml de la aplicación:
<servlet>
  <servlet-name>dwr-invoker</servlet-name>
  <display-name>DWR Servlet</display-name>
  <description>Direct Web Remoter Servlet</description>
  <servlet-class>uk.ltd.getahead.dwr.DWRServlet</servlet-class>
  <init-param>
    <param-name>debug</param-name>
    <param-value>true</param-value>
  </init-param>
</servlet>
<servlet-mapping>
  <servlet-name>dwr-invoker</servlet-name>
  <url-pattern>/dwr/*</url-pattern>
</servlet-mapping>
Luego crearemos un fichero WEB-INF/dwr.xml donde especificaremos qué métodos de qué beans queremos "exponer" mediante dwr, y que beans van a servir de transporte de datos y por lo tanto dwr debe convertir.
Por ejemplo, si queremos llenar una lista desplegable con categorías (paises, por ejemplo) y otra dependiente de esta (ciudades), necesitamos dos métodos de un bean Java (ciudadesManager), y un DTO para transferencia de datos (ListBean).
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE dwr PUBLIC
  "-//GetAhead Limited//DTD Direct Web Remoting 0.4//EN"
  "http://www.getahead.ltd.uk/dwr/dwr.dtd">

<dwr>
  <allow>
    <create creator="spring" javascript="ciudadesManager" beanName="ciudadesManager">
      <include method="getPaises"/>
      <include method="getCiudades"/>
    </create>
    <convert converter="bean" match="com.package.ListBean" />
  </allow>
</dwr>
Consecuentemente, en nuestro beans.xml estará el bean ciudadesManager:
<bean id="ciudadesManager" class="com.package.ciudadesManager">
  <property name="paisesDAO" ref="paisesDAO"/>
  <property name="ciudadesDAO" ref="ciudadesDAO"/>
</bean>
Llegados a este punto, lo que queda es desarrollar la página de nuestra aplicación, y para ello deberemos incluir el javascript necesario para acceder al ciudadesManager (recordando actualizar el [appfolder]:
<script type='text/javascript' src='/[appfolder]/dwr/interface/ciudadesManager.js'></script>
<script type='text/javascript' src='/[appfolder]/dwr/engine.js'></script>
<script type='text/javascript' src='/[appfolder]/dwr/util.js'></script>
El primer include corresponde al javascript que DWR generará automaticamente para nuestro bean ciudadesManager, el segundo es el core de DWR, y el tercero una serie de utilidades para manipular controles html, como gets y sets de propiedades.
Las funciones javascript necesarias para acceder remotamente a los métodos del bean se dividen en dos: uno que hace la llamada y otro de callback. Asi, para llenar la lista de paises crearemos las funciones execPaises y fillPaises, y para llenar la lista de ciudades execCiudades y fillCiudades:
<script>
  function execPaises() {
      ciudadesManager.getPaises(fillPaises);
  }

  function fillPaises(data) {
      DWRUtil.fillList('paises', data, 'key', 'value');
  }

  function execCiudades() {
    DWRUtil.removeAllOptions('ciudades');
    ciudadesManager.getCiudades(fillCiudades, DWRUtil.getValue('paises'));
  }

  function fillCiudades(data) {
      DWRUtil.fillList('ciudades', data, 'key', 'value');
  }

</script>
La primer funcion, execPaises, la llamaremos al inicio de la página, dentro del onLoad del body. Al ejecutarse, llamará al método getPaises de ciudadesManager y el resultado lo tendremos en la función que le pasemos como parámetro, en este caso fillPaises.
Dentro de fillPaises utilizaremos la función DWRUtil.fillList para rellenar la lista desplegable cuyo id es paises con la lista de datos recibidos, diciéndole cuál propiedad corresponde al código y cuál a la descripción.
Análogamente, la función execCuidades estará en el onChange de la lista paises, y cuando se ejecute (cada vez que cambiemos de pais) borrará todas las opciones de la lista ciudades y ejecutará el método getCiudades, pasando como parámetro el value de la lista paises (el pais elegido).
El código de las listas quedará asi:
<select id="paises" onChange="execCiudades();"></select>
<select id="ciudades"></select>
Solo nos queda codificar el bean ciudadesManager y el DTO. El manager obtiene la lista de paises o ciudades utilizando un DAO y las trasnfiera al DTO. Cabe señalar que podríamos utilizar directamente los beans Pais y Ciudad y transferirlos a la página, pero estas clases suelen tener muchas mas propiedades que no utilizaríamos y penalizaría la performance. De cualquier modo dependerá de vuestra propia aplicación como hacerlo, esta es solamente una forma mas.
public class CiudadesManager {

    private DAO paisesDAO = null;
    private DAO ciudadesDAO = null;

    public Object[] getPaises() {
        List objects = getPaisesDAO().findByNamedQuery("allPaises");
        List list = new ArrayList();
        for (Iterator it=objects.iterator(); it.hasNext(); ) {
            Pais pais = (Pais)it.next();
            ListBean bean = new ListBean(pais.getCodigo(), pais.getNombre());
            list.add(bean);
        }
        return list.toArray();
    }

    public Object[] getCiudades(String idPais) throws BusinessException {
        List objects = getCiudadesDAO().findByNamedQuery("byPais", new Object[]{idPais});
        List list = new ArrayList();
        for (Iterator it=objects.iterator(); it.hasNext(); ) {
            Ciudad ciudad = (Ciudad)it.next();
            ListBean bean = new ListBean(ciudad.getCodigo(), ciudad.getNombre());
            list.add(bean);
        }
        return list.toArray();
    }

    public DAO getPaisesDAO() {return paisesDAO;}
    public void setPaisesDAO(DAO paisesDAO) {this.paisesDAO = paisesDAO;}
    public DAO getCiudadesDAO() {return ciudadesDAO;}
    public void setCiudadesDAO(DAO ciudadesDAO) {this.ciudadesDAO = ciudadesDAO;}

}

public class ListBean {

    private String key = null;
    private String value = null;

    public ListBean (String key, String value) {
        this.key = key;
        this.value = value;
    }

    public String getKey() {return key;}
    public String getValue() {return value;}
    public void setKey(String key) {this.key = key;}
    public void setValue(String value) {this.value = value;}
}
Si todo ha sido configurado correctamente, el resultado será una lista desplegable de paises que se llena al cargar la página:y una lista desplegable de ciudades que se refresca cada vez que cambiamos la primera:Y todo sin que se refresque la página.
En el sitio de DWR hay numerosos ejemplos de como utilizarlo para diversas tareas, como editar tablas y formularios o validar datos, solo hace falta animarse.
jueves, agosto 11, 2005
Mule
Con el auge de SOA estuve experimentando con Mule como parte de la estrategia opensource de un cliente.
Resulta admirable que con tan solo (o casi solo) una configuración similar a esta:
Este mensaje puede ser reenviado mediante diversos medios de transporte, como JMS (en mi caso), archivos, ftp, http, soap, pop/smtp.
Muy útil, como se ve, para "conectar" sistemas muy dispares y "orquestar" el buen funcionamiento entre ellos.
Resulta admirable que con tan solo (o casi solo) una configuración similar a esta:
se pueda exponer un servicio via webservices, el cual derivará el mensaje a una lista (StaticRecipientList) de destinos que proveerá la implementación (ServiceDomainRouterImpl).
<bean id="domainRouterEP" class="org.mule.impl.endpoint.MuleEndpoint">
  <property name="endpointURI">
    <bean class="org.mule.impl.endpoint.MuleEndpointURI">
      <constructor-arg value="axis:http://${broker.host}:${broker.ws.port}/router"/>
    </bean>
  </property>
  <property name="synchronous" value="true"/>
</bean>

<bean id="serviceDomainRouter" class="org.mule.impl.MuleDescriptor">
  <property name="inboundEndpoint" ref="domainRouterEP"/>
  <property name="outboundRouter">
    <bean class="org.mule.routing.outbound.OutboundMessageRouter">
      <property name="routers">
        <list>
          <bean class="org.mule.routing.outbound.StaticRecipientList"/>
        </list>
      </property>
    </bean>
  </property>
  <property name="implementation" value="serviceDomainRouterImpl"/>
  <property name="properties">
    <map>
      <entry key="axisOptions">
        <map>
          <entry key="wsdlServiceElement" value="RouterService"/>
          <entry key="wsdlPortType" value="RouterPort"/>
        </map>
      </entry>
      <entry key="serviceInterfaces">
        <list>
          <value>broker.router.ServiceDomainRouter</value>
        </list>
      </entry>
    </map>
  </property>
</bean>

<bean id="serviceDomainRouterImpl" class="broker.router.impl.ServiceDomainRouterImpl"
  singleton='false'>
  <property name="hub" value="${broker.hub}"/>
  <property name="directory" ref="directory"/>
  <property name="schemaFileName" value="request-schema.xsd"/>
</bean>
Este mensaje puede ser reenviado mediante diversos medios de transporte, como JMS (en mi caso), archivos, ftp, http, soap, pop/smtp.
Muy útil, como se ve, para "conectar" sistemas muy dispares y "orquestar" el buen funcionamiento entre ellos.
Suscribirse a:
Entradas (Atom)